
百度在 2026 年 11 月 5 日放出 ERNIE-5.5-Flash-Base:一個總參數 280B、每 token 只啟動 14B 的稀疏 MoE 語言模型,權重停在前訓練結束的那一刻,沒有經過任何中期訓練或後訓練。官方把它定位成「進一步訓練的起點」,而不是能直接對話的成品。
模型從零開始訓練,吃下 33.5T token,訓練脈絡一路拉長到 128K,微調與推論則支援 100 萬 token。架構上做了不少客製:混合稀疏注意力、多路由潛在 MoE、以流形約束的超連接、可學習分段溫度的輸出頭,以及用 ECHO 取代傳統 MTP 模組。
這篇是官方公告的繁中全文翻譯,後面附上 Hacker News 上將近一百則留言的討論整理。
為什麼要發一個 base model
base model 的價值有兩層:前訓練已經建立起來的能力,以及它作為後續訓練起點的可塑性。不同領域、不同推理任務與 agent 應用,需要不同的資料、訓練目標與行為模式。把前訓練結束時的權重放出來,開發者就能站在既有的通用能力上,自己決定要往哪裡走。
這次釋出的 ERNIE-5.5-Flash-Base 是稀疏 MoE 模型,總參數 280B,每 token 啟動 14B。前訓練用了 33.5T token,訓練脈絡最長 128K,微調與推論支援 100 萬 token 脈絡。權重是前訓練結束的檢查點,可以當作領域適應、指令微調與強化學習研究的共同起點。
一個 base model 要值得被拿來繼續訓練,前提是訓練與執行都還負擔得起,所以效率從一開始就是設計目標。後續訓練會反覆對模型取樣,agent 應用帶來多輪互動與長脈絡,兩者都在推高算力與記憶體成本。ERNIE 5.5 Flash 因此在每個元件上重新檢視能力與效率的取捨:從注意力、殘差連接到 MoE 層與輸出頭,把啟動算力、KV cache 與長脈絡成本放在一起衡量,而不是逐項分別最佳化。
同樣的思路也決定了資料與訓練系統。訓練的每個後續階段,都建立在前訓練給的基礎上,所以語料特別強調那些事後很難補的能力,例如倉庫規模的程式碼與長脈絡理解。而效率架構只有在也能被高效率地大規模訓練時才成立,因此模型與訓練系統是一起設計的。
官方希望這次釋出能讓更多開發者省下大規模前訓練的成本,把資源留給自己在意的能力、任務與訓練方法。
四個重點:
- 開放的再訓練起點:沒有中期或後訓練的 base 權重,社群可以自己走領域適應、推理或 agent 訓練的路線。
- 為高效率的後續訓練與推論而設計:稀疏 MoE 與混合稀疏注意力,在架構層面平衡模型容量、啟動算力與長脈絡成本。
- 資料面廣、訓練效率高:多元且高品質的前訓練語料,替後續訓練鋪好基礎;訓練系統與架構共同設計,讓大規模前訓練維持效率。
- 乾淨的研究基線:單一前訓練結束檢查點,方便在受控條件下比較各種訓練方法,衡量每一種方法到底加了多少。
模型架構
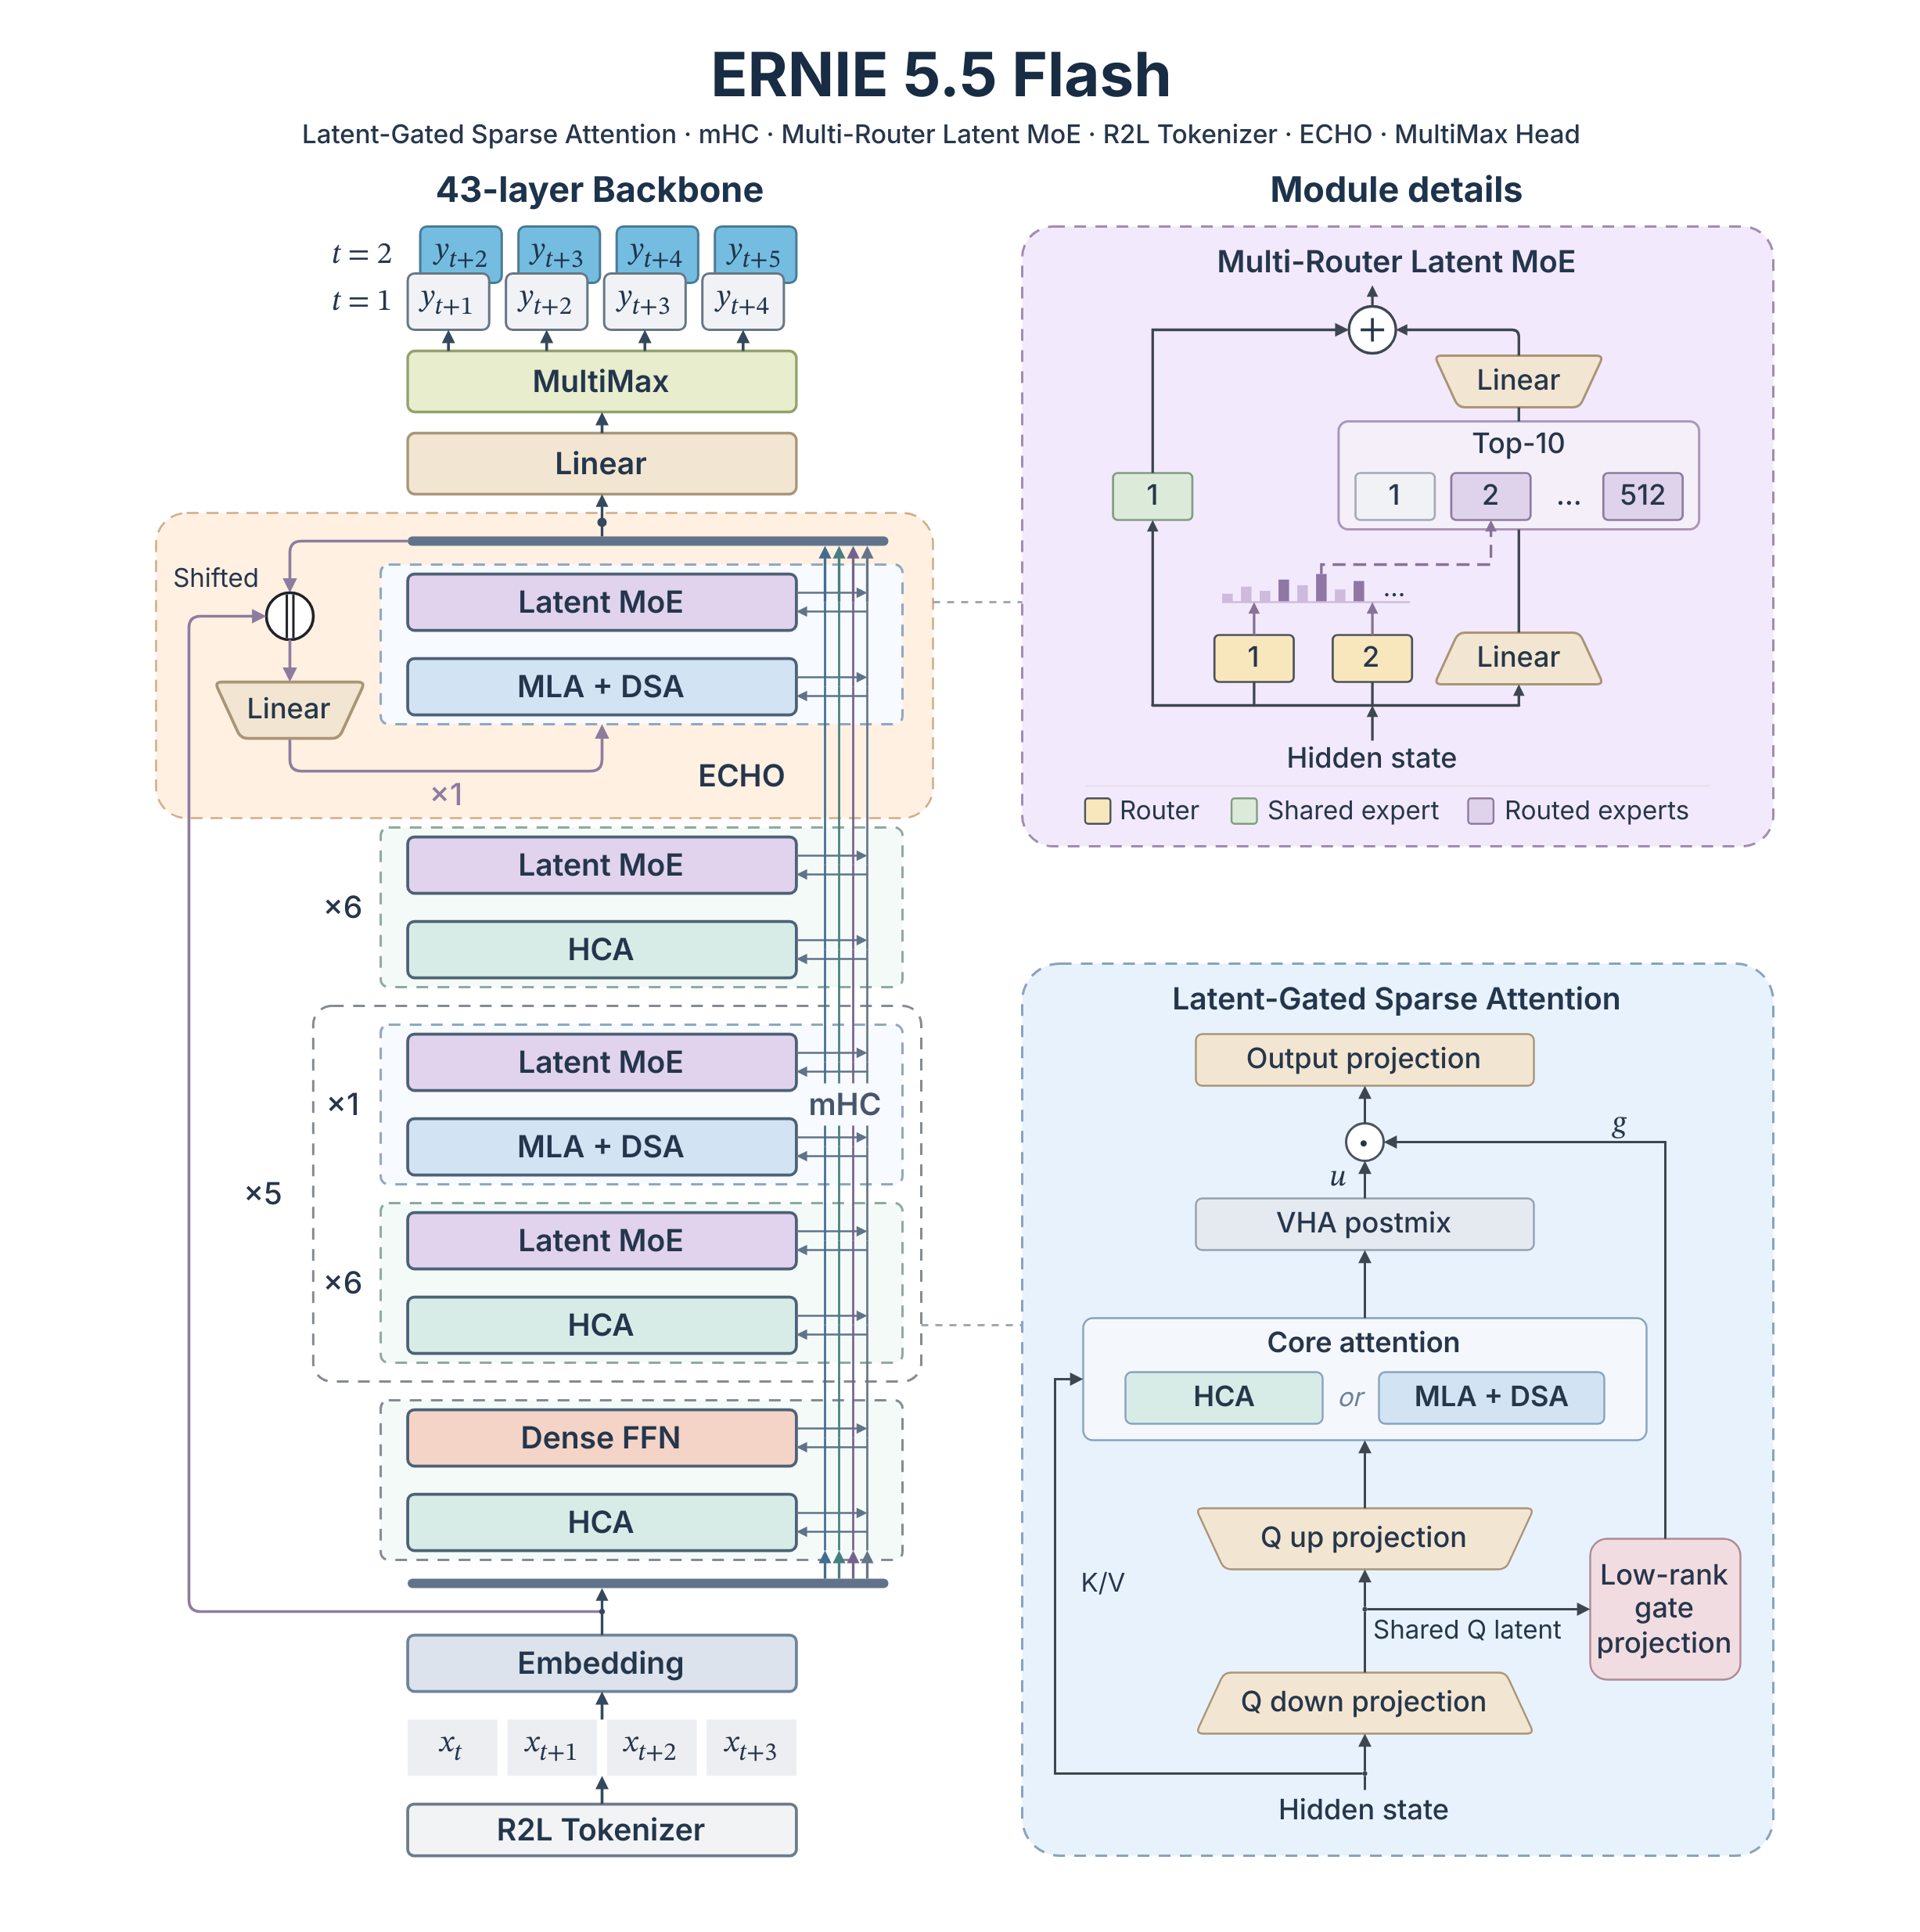
ERNIE 5.5 Flash 有 43 層 Transformer,hidden size 4096,64 個注意力頭。

潛在閘控稀疏注意力(Latent-Gated Sparse Attention)
混合 MLA 與 HCA:多數層只需要對久遠的過去有粗略概念,所以每七層只有一層保留對全脈絡的 token 級存取,用的是多頭潛在注意力(MLA)。其餘層改用重壓縮注意力(HCA):把每 128 個 token 壓成一筆快取條目,再對這批條目加上一小段最近、未壓縮的 token 做注意力。HCA 層仍然看得到整個序列,但只需要快取全脈絡層的一小部分。
逐層設定頭維度:不再讓每一層用同樣的頭維度,而是看各層注意力的成本:便宜的層配寬頭,昂貴的層配窄頭。HCA 層的注意力,作用在壓縮 128 倍的序列上,本身很便宜,可以負擔 512 維的寬頭而幾乎不增加算力。MLA 層在 token 層級運算,成本較高,query/key 與 value 都用 256 維的窄頭。
把 KV cache 預算集中在 MLA 層:既然多數層是 HCA,剩下的問題就是 KV cache 預算該花在哪。一個選項是放很多壓縮稀疏注意力(CSA)層,把歷史壓 4 倍、只注意其中被選中的部分。官方改用少數幾層保留全部 token 的 MLA。在相近的 KV cache 預算下做前訓練比較,HCA 搭 MLA 的表現優於 HCA 搭 CSA。
全脈絡層也用稀疏注意力:MLA 層是唯一逐個看到久遠 token 的層,若用稠密注意力,在長脈絡下會吃掉大部分注意力算力,所以改用稀疏注意力(DSA)。一個輕量 indexer 為每個 query 對過去位置打分,核心注意力只在分數最高的 top-k 位置上計算。如此一來,核心注意力的單一 query 成本不隨脈絡成長。加上 DSA 之後,這些層的前訓練 loss 與稠密注意力相當,訓練速度則快得多。
注意力層內還有兩項改動:
- 低秩閘控注意力(Low-Rank Gated Attention):閘控注意力把注意力輸出乘上一個學出來的閘,已知能同時改善品質與訓練穩定性。一般做法是從該層的 hidden state 算出閘;這裡改成從低秩 query latent 算,那是每個注意力層本來就會算的壓縮版 query。這個 latent 比 hidden state 窄 4 倍,閘的投影因此少了 75% 權重,消融實驗也顯示表現更好。ERNIE 5.5 Flash 的每個注意力層,MLA 與 HCA 都採用低秩閘控注意力。
- 虛擬頭注意力(Virtual Head Attention, VHA):注意力之後,VHA 加上一個輕量的低秩混合步驟,跨頭交換資訊,並帶一條 identity 跳接。這讓各頭能共享資訊,讓表達力與訓練品質更好,推論時被融進注意力 kernel,額外開銷可忽略。
多路由潛在 MoE(Multi-Router Latent MoE)
傳統 MoE 層用單一路由器配上硬式 top-k 挑專家。官方發現,單一路由器打出的分數,與每個專家實際有用的程度只有弱相關,在模型的中段與深層尤其明顯。而被排除在 top-k 之外的專家,收不到該 token 的梯度,路由器也就得不到「自己選錯了」的訊號,錯的選擇容易自我強化。
Multi-Router 把單一路由器換成數個獨立初始化的 sigmoid 路由器,共同為專家打分。這些路由器會發展出明顯不同的偏好:某個專家可能是因為某個路由器特別偏好它,也可能是因為好幾個路由器一起偏好它,因此選錯比較容易修正。任何一個路由器的誤判都不再單獨決定選擇,路由對雜訊特徵與分布偏移也就不那麼敏感。啟動的專家數、專家 FLOPs 與通訊量維持不變。與單一路由器相比,路由分數與專家實際有用程度明顯更相關,中層與深層的改善最大。
除了第一層,其餘各層都用 MoE 前饋區塊:
- 512 個路由專家(top-10)加 1 個共享專家,採無輔助損失、偏差修正的負載平衡。
- 潛在專家:每個 MoE 層先把 token 從 4096 投影到 2048 維的潛在空間,專家(中間維度 2048)在這個空間裡運算,再由一個共享的上投影映回 4096。相對於全寬專家,dispatch/combine 流量與專家 FLOPs 大約減半。
- 可學習純量的穩定 LatentMoE 設計:MoE 區塊遵循 Stable LatentMoE 設計(上投影前加 RMSNorm、專家採 SiTU-GLU 活化),讓 43 層的專家輸出維持良好尺度、最佳化更穩定。另外,每個路由專家,再把自己的路由權重乘上一個可學習純量。
流形約束超連接(mHC)
ERNIE 5.5 Flash 以 mHC 取代標準殘差連接:每一層透過一個受約束的混合矩陣,對 4 條平行的殘差流讀寫,讓層與層之間傳遞資訊的通道更寬,額外算力卻可忽略。
MultiMax 輸出頭
單一的 softmax 溫度必然要取捨:調低讓分布變稀疏,卻也壓掉其他合理的 token;調高留下它們,卻讓不合理的長尾變肥。MultiMax 用可學習的分段溫度取代單一溫度,輸出頭就不必二選一:既壓制不合理的長尾,又保住好幾個合理的下一個 token。logits 在分塊、Triton 融合的交叉熵 kernel 裡、softmax 之前逐元素重新縮放。訓練開銷可忽略、不佔額外記憶體,前訓練 loss 明顯下降。
ECHO:取代 MTP 模組
傳統的多 token 預測(MTP)在骨幹上外掛額外模組來預測未來 token,於是未來 token 的 loss 主要拿來訓練那些模組,骨幹仍然主要在學預測下一個 token。ERNIE 5.5 Flash 改用 ECHO 取代 MTP 模組,直接複用骨幹自己的最後一層來預測未來 token。因為沒有獨立的 MTP 層,未來 token 的 loss,直接訓練產生下一個 token 的那批參數。學會看向下一個 token 之後,骨幹被推動去預判序列要走的方向,在推理與程式碼上的增益明顯。ERNIE 5.5 Flash 以單步 ECHO 前訓練。這一層同時充當投機解碼的草稿模型,而且泛化超出訓練設定:雖然只被訓練預測額外一個 token,實際能往前起草好幾個 token,接受率比同樣訓練方式的輔助 MTP 模組更高。
分詞器
ERNIE 5.5 Flash 使用新的 BPE 分詞器,詞表約 20 萬筆。數字以右到左(R2L)、每組最多三位數的方式分詞,讓不同位數的數字裡、同位值的數位能對齊(例如 1,234,567 切成 1、234、567)。這對算術與數字密集的文字有幫助。
預訓練
ERNIE-5.5-Flash-Base 從零開始前訓練 33.5T token,使用 Muon 最佳化器與 FP8 混合精度。訓練脈絡在前訓練過程中逐步拉長到 128K token,微調與推論支援 100 萬 token 脈絡。釋出的檢查點取在前訓練結束,未經過任何中期訓練或後訓練。
資料
前訓練語料涵蓋多領域、多語言,兼顧知識廣度與品質。除了這層基礎,官方特別著力三個方向:
- 網頁資料:大規模抓取多語言網頁,以高保真度抽取,再用多維度打分模型過濾品質。成果涵蓋廣泛知識,且訓練訊號密集。
- 程式碼資料:從倉庫與網頁蒐集程式碼,過濾掉非程式碼內容、積極去重、並在多個粒度上評分。除了靜態程式碼,語料還包含軟體如何演進與執行的資料:commit、issue、pull request、code review、從需求到 PR 的過程、多 commit 軌跡、生成的測試,以及經過 CI 驗證的修補。這些資料針對倉庫級推理與 agent 軟體工程。
- 長脈絡資料:三個互補來源——挑選有長距相依、並以 embedding 去重、LLM 品質評分與規則清理過的自然長文件;把自然文字與檢索到、語意相近的干擾項,串接而成的長序列;以及針對 MRCR 式檢索、引用有據的問答,以及多跳問答的合成資料。
訓練基礎設施
這次跑出兩項基礎設施:一個在上千顆 GPU 上仍有效率的分散式 Muon 最佳化器,以及針對大頭維度的注意力 kernel FlashMask-4。
分散式 Muon。與 Adam 這類逐元素最佳化器不同,Muon 對每個參數矩陣的更新整體做正交化,這改變了分散式訓練的通訊方式,也改變記憶體在 GPU 之間的分佈。兩項最佳化讓它在數千顆 GPU 的規模下可行:
- 通訊高效的更新:按照慣例,稠密參數會走一條穿過叢集每顆 GPU 的單一環路同步。資料以大量小訊息跨越一長串跨節點連結,連結利用率低,延遲與抖動隨叢集變大而惡化。MoE 參數的同步方式不同:每顆 GPU 只與其他節點上同 rank 的 GPU 交換資料。官方把稠密參數的同步搬到同一條路徑上,並把稠密與 MoE 的傳輸合併成一次集體操作。訊息變大,頻寬用得更滿;通訊模式更規律,符合專家平行通訊;跨節點延遲與抖動明顯下降。最佳化器的更新內容完全沒變。
- 記憶體平衡的分片:Muon 需要大訊息才能高效通訊,所以直覺的分片方式會把許多參數張量綁在一起、放在前幾顆 GPU 上。少數節點因此持有遠多於其他節點的最佳化器狀態,容易 OOM,存檔與上下傳檢查點也慢,故障恢復時間拉長,而且問題隨 GPU 數量惡化。官方的跨節點平衡分片把這些最佳化器狀態攤到更多 GPU 上,包含排序後段的那些。記憶體在節點間幾乎平均,訊息又仍大到足以高效通訊。
針對大頭維度的 FlashMask-4。頭維度一大,FlashAttention 系 kernel 就撞上共享記憶體、tensor memory 這類晶片上儲存的極限:算力利用率下滑,有些組態甚至難以實作。FlashMask-4 建在 CuTe-DSL 上,同時支援 SM90 與 SM100 GPU,用 2-CTA 分塊平行運算繞開限制,在 SM100 上還加上 tensor memory 的雙緩衝輪替。它保留 FlashMask 緊湊的 O(N) 逐欄遮罩表示法,也仍跳過全遮罩的區塊。它支援到 qk_head_dim = 576、v_head_dim = 512,超出 FlashAttention-4 的範圍。在 SM100 GPU 上,前向比 FlashAttention-4 MaskMod 快最多 175%,反向快最多 74%。
評測
設定
比較對象挑了釋出當時公開可得、規模相近的最新開源 base 模型:DeepSeek-V4-Flash-Base(284B-A13B)、Hy3-preview-Base(295B-A21A)與 MiMo-V2.5-Base(310B-A15B)。四個模型都以公開釋出的檢查點、同一套評測框架、同樣的提示詞與 few-shot 範例評估,自由形式的問答也用同一個 LLM 評審。
總體結果
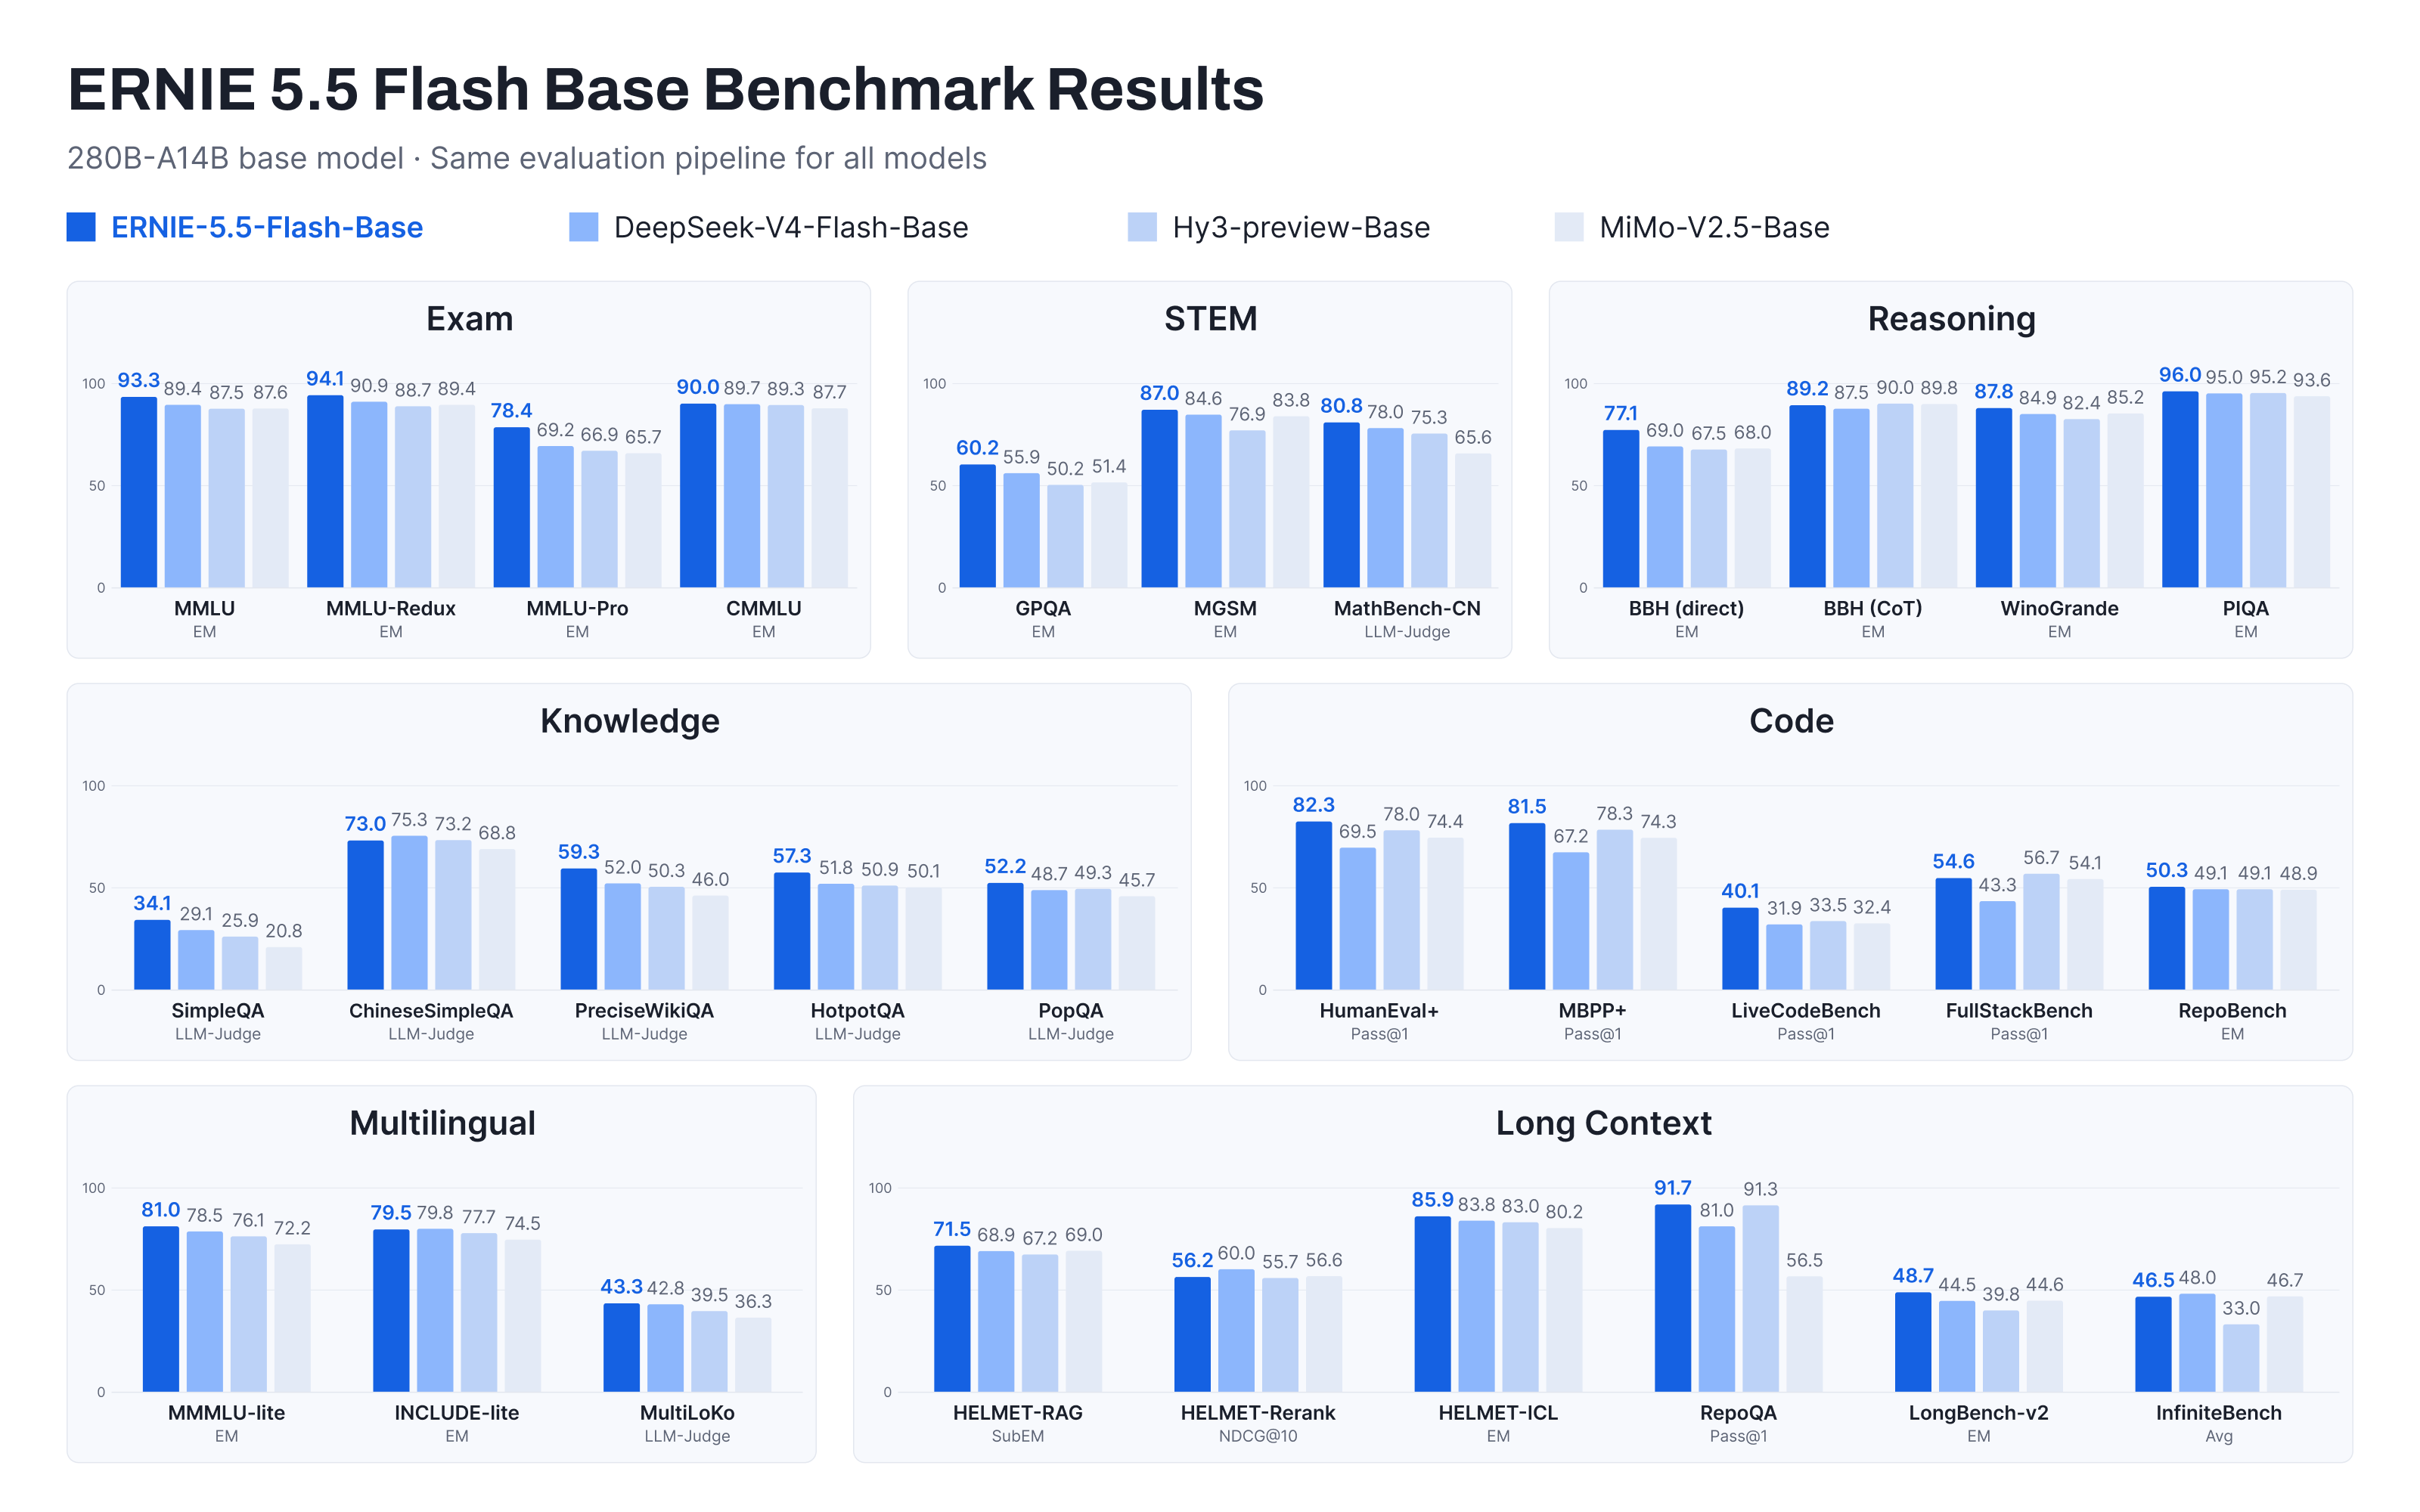

ERNIE-5.5-Flash-Base 在各個評測類別都表現強勢,推理、程式碼與考試類是它最好的成績。這裡有個細節:雖然 43 層裡有 37 層,其注意力作用在壓縮 128 倍的序列上,那六層 MLA-DSA 已足以讓六項長脈絡評測維持強度。
細部結果
| 評測(指標/shot) | ERNIE 5.5 Flash | DeepSeek V4 Flash | Hy3 preview | MiMo V2.5 |
|---|---|---|---|---|
| 知識與學術 | ||||
| MMLU(EM, 5-shot) | 93.3 | 89.4 | 87.5 | 87.6 |
| MMLU-Redux(EM, 5-shot) | 94.1 | 90.9 | 88.7 | 89.4 |
| MMLU-Pro(EM, 5-shot) | 78.4 | 69.2 | 66.9 | 65.7 |
| CMMLU(EM, 5-shot) | 90.0 | 89.7 | 89.3 | 87.7 |
| SimpleQA(LLM-Judge, 10-shot) | 34.1 | 29.1 | 25.9 | 20.8 |
| ChineseSimpleQA(LLM-Judge, 10-shot) | 73.0 | 75.3 | 73.2 | 68.8 |
| PreciseWikiQA(LLM-Judge, 10-shot) | 59.3 | 52.0 | 50.3 | 46.0 |
| HotpotQA(LLM-Judge, 10-shot) | 57.3 | 51.8 | 50.9 | 50.1 |
| PopQA(LLM-Judge, 10-shot) | 52.2 | 48.7 | 49.3 | 45.7 |
| STEM 與推理 | ||||
| GPQA(EM, 5-shot) | 60.2 | 55.9 | 50.2 | 51.4 |
| MGSM(EM, 8-shot CoT) | 87.0 | 84.6 | 76.9 | 83.8 |
| MathBench-CN(LLM-Judge, 5-shot) | 80.8 | 78.0 | 75.3 | 65.6 |
| BBH direct(EM, 3-shot) | 77.1 | 69.0 | 67.5 | 68.0 |
| BBH CoT(EM, 3-shot CoT) | 89.2 | 87.5 | 90.0 | 89.8 |
| WinoGrande(EM, 5-shot) | 87.8 | 84.9 | 82.4 | 85.2 |
| PIQA(EM, 5-shot) | 96.0 | 95.0 | 95.2 | 93.6 |
| 多語 | ||||
| MMMLU-lite(EM, 5-shot) | 81.0 | 78.5 | 76.1 | 72.2 |
| INCLUDE-lite(EM, 5-shot) | 79.5 | 79.8 | 77.7 | 74.5 |
| MultiLoKo(LLM-Judge, 5-shot) | 43.3 | 42.8 | 39.5 | 36.3 |
| 程式碼 | ||||
| HumanEval+(Pass@1, 1-shot) | 82.3 | 69.5 | 78.0 | 74.4 |
| MBPP+(Pass@1, 0-shot) | 81.5 | 67.2 | 78.3 | 74.3 |
| LiveCodeBench(Pass@1, 1-shot) | 40.1 | 31.9 | 33.5 | 32.4 |
| FullStackBench(Pass@1, 1-shot) | 54.6 | 43.3 | 56.7 | 54.1 |
| RepoBench(EM, 0-shot) | 50.3 | 49.1 | 49.1 | 48.9 |
| 長脈絡 | ||||
| HELMET-RAG(SubEM, 2-shot) | 71.5 | 68.9 | 67.2 | 69.0 |
| HELMET-Rerank(NDCG@10, 0-shot) | 56.2 | 60.0 | 55.7 | 56.6 |
| HELMET-ICL(EM, many-shot) | 85.9 | 83.8 | 83.0 | 80.2 |
| RepoQA(Pass@1, 0-shot) | 91.7 | 81.0 | 91.3 | 56.5 |
| LongBench-v2(EM, 0-shot) | 48.7 | 44.5 | 39.8 | 44.6 |
| InfiniteBench(Avg, 0-shot) | 46.5 | 48.0 | 33.0 | 46.7 |
粗體是各列最佳成績。
快速上手
權重分 FP8 與 BF16 兩種 safetensors,放在 Hugging Face,授權是《ERNIE 5.5 Flash 基礎模型授權協議 v1.0》。模型要求每個輸入開頭都有 BOS token,分詞時請保留 add_special_tokens=True。
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

model_name = "baidu/ERNIE-5.5-Flash-Base-BF16"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name, torch_dtype=torch.bfloat16, device_map="auto")
model_inputs = tokenizer(["The hybrid attention architecture of ERNIE 5.5 Flash"], add_special_tokens=True, return_tensors="pt").to(model.device)
print(tokenizer.decode(model.generate(**model_inputs, max_new_tokens=256)[0], skip_special_tokens=True))
SGLang 與 vLLM 都透過 completions API 服務這個模型,部署細節看 model card。微調參考官方的 ERNIE 5.5 範例。
Hacker News 上的討論焦點
手機版或嵌入失敗時,直接開懶人包頁面。
討論熱度(2026 年 11 月 6 日抓取):175 分、96 則留言、15 個頂層討論,本次讀完全部 96 則,含各層回覆。留言沒有分數欄位,熱門串按回覆量排序取。
一、授權條款直接排除歐盟、英國與南韓
最大的一串(24 則)不是談技術,而是談授權。開串的 mkl 直指條款太嚴:這個模型本來就是要讓人拿去繼續訓練的:整個歐盟、英國與南韓被禁止使用,而且使用者還得負責確保這些地區沒有人使用自己的衍生模型。
- 把它讀成法遵免責:Aurornis 認為這是在替自己洗掉處理這些地區 AI 法令的麻煩,與 GDPR 剛上路時一堆網站乾脆封鎖歐盟訪客同一個邏輯——不是在意你做什麼,而是留一個逃生條款。
- 責任轉嫁給下游:antman 與 simonh 的說法一致:百度大概不會真的去追,但監管責任已經轉給採用者。bilbo0s 講得更直白:他們只需要勾一個「我告訴過你」的框,剩下的舉證責任丟給各國。
- 法規成因:ricardobeat 引歐盟 AI 法第 53 條,指通用模型要在歐盟上市就得保留技術文件、向 downstream 開發者提供資訊、採用著作權合規政策並公開訓練內容摘要——開放權重模型只有部分豁免,成本不低。
- 能不能執行:breakingcups 認為根本難以執行,gpm 追問美國有哪個法院認定權重受著作權保護,noselasd 則提醒民事訴訟照樣能走。
二、「ERNIE 聽起來很老」與一長串命名梗
第二大的串(23 則)幾乎全是玩笑。開串的 speedping 說,ERNIE 這名字像 BERT 時代的產物,該重新命名或者乾脆擁抱遠古 ML 風格。下面立刻歪成芝麻街、經典 BERT 模型與各國旗艦模型縮寫的接龍,還有人拿 1950 年代英國彩券開獎機也叫 ERNIE 來考據。少數認真的分支在討論 BERT 類模型今天仍然堪用。lofties 說,連最新的那票大型模型,在某些任務上都打不贏訓練良好的 BERT。
三、base model 是對齊策略還是災難
第三串(18 則)從「很高興看到 base model 回來了」一路吵到文明級對齊。txrx0000 的原始論點是:讓全世界各自用自己的價值觀去對齊同一個 base model,失敗的人很多,但方向互相抵消,最後收斂到人類的平均目標函數。
- 懷疑 base model 到底能幹嘛:stingraycharles 直接問,這是不是就是只會接龍、沒有推理與對齊優化的前一代模型;stymaar 補了定義——就是純 next-token 預測訓練出來的東西,沒有 RLHF、沒有指令跟隨、沒有 RLVR。
- 成本比例之爭:londons_explore 說大型 base model 佔做一個前沿模型約九成的心力與成本,剩下那一成才是爭議所在;stymaar 反駁這個數字是舊時代的遺產,現在後訓練吃掉一半以上的訓練算力,zozbot234 也同意後訓練比重遠高於幾個百分點。
- 反方最強的一擊:jrflo 直指這套邏輯顛倒了——「只要有人做出來,所有人都完蛋」,不是「所有人都做出來就沒事」。cubefox 補刀說攻擊通常比防禦容易,一個能力足夠又錯位的模型,其他對齊模型幫不上忙。txrx0000 的回應是:那只有在算力集中、少數人能造出無人能抗衡的模型時才成立。
四、評測挑的對手對不對
A_D_E_P_T 認為 ERNIE 這顆比 Qwen3.8-27B 與 DeepSeek-v4-Flash 更強,而後兩者是目前最好的 base model。質疑立刻上門:input_sh 指出官方比的是 DeepSeek-V4-Flash,不是更新版 V4.1、也不是 V4.1-1017,等於差了兩個版本;Tepix 與 segmondy 反駁說 V4.1 Flash 體積是這顆的兩倍、在地端難跑,而且 base 對 base 才合理。input_sh 再澄清 V4.1 是從零重建的架構、不是從 V4 後訓練而來。另一條分支在爭 Qwen 到底有沒有公開 base 版本,最後落在「Qwen3 與 3.5+ 的架構其實很不一樣」這個共識。halJordan 則澆冷水,認為百度、騰訊這類二線中國實驗室的模型都在刷榜,發表的首要目的是給官方看數字。
五、硬體與量化:2×128GB 起跳
Tepix 說這個尺寸不錯,4bpw 以上的量化可以塞進 2×128GB。jpitz 反問:14B 啟動的 MoE,不是該塞進更小的環境嗎,horsawlarway 給出實算:決定 VRAM 需求的是總參數不是啟動參數,4-bit 量化下要跑滿 100 萬脈絡大約需要 175GB,其中約 150GB 是權重,KV cache 只佔 3 到 5GB(HCA 壓縮幫上忙),再加一點併發餘裕;6-bit 量化要跑滿長脈絡則約 244GB。
六、實務問題與雜訊
有人問多節點 infiniband 叢集該用哪個框架續訓(NeMo、TRL+Accelerate),沒人給出定論。有人問這顆好不好用,被提醒它沒做指令微調、拿去跑 coding agent 不會好用。也有一位老使用者的回顧:ERNIE 4 當年很實在、講重點,可惜正好撞上 DeepSeek V3 與 GLM 起飛。剩下的就是「中國模型 slop」這類一句話。
結語
ERNIE-5.5-Flash-Base 的出發點只有一句:一個要讓人繼續訓練的 base model,應該在設計上就有效率。官方在注意力、殘差連接、MoE 層與輸出頭每個元件上平衡能力與效率,架構背後有廣泛而高品質的前訓練資料,以及與模型一起設計的訓練系統。每 token 啟動 14B、KV cache 精簡,這顆模型在包含長脈絡的廣泛評測上表現強勢。
base model 只是起點,後訓練版的 ERNIE 5.5 Flash 會隨後跟上。至於社群會在這上面長出什麼——領域適應、推理或 agent——那才是這次釋出真正的看點。