
資料倉儲廠商 Hightouch 拿自家最頭痛的工作做實驗:判斷身分解析(identity resolution)有沒有出錯,把不同的人錯誤合併成一個。這件事過去只能靠人工抽樣,每小時約 50 個身分,慢到讓團隊花幾個月才敢說自家的比對邏輯有沒有在正常運作。
他們的結論很直接:便宜的小模型不需要很強,只要知道自己什麼時候不確定。Jev 把 22% 的案例轉給 Claude Opus,準確度 98.8%,單獨用 Opus 是 99.0%,成本從每 1,000 個身分 3.86 美元降到 0.88 美元。
什麼是身分解析,為什麼難
身分解析是把資料紀錄對應到真實人物的過程。形式上,給定一組紀錄 D,你要決定一組身分 I 與對應關係 m(D)->I,使得每筆紀錄對應到某個身分,每個身分恰好對應現實中的一個人,而且沒有兩個身分指向同一個人。
這是所有做客戶觸達、個人化、客戶分析的公司的地基。你沒辦法把一位客戶的所有消費對應到單一身分,就無從算出他的終身價值。
實務上麻煩在雜訊。人們會共用 email、搬家、填錯字。原文列了一張錯誤對照表,同一個現象往往有兩種完全相反的解釋:
| 錯誤類型 | 看起來像 | 但也可能是 |
|---|---|---|
| 打字錯誤 | Valentino → Valentinp | 另一個姓氏 |
| 字元誤讀 | Sam → 5am | 垃圾值,或使用者名稱 |
| 依讀音拼寫 | Phillips → Filips | 另一個家族 |
| 月日互換 | 02/17/2020 → 17/02/2020 | 解析不出來的生日 |
| 從親屬複製的值 | 小孩的紀錄掛了家長的生日 | 一個與小孩同名的成人 |
| 暱稱 | Robert → Bob | 兩個兄弟 |
| 佔位名稱 | Valentino → Female Child | 完全沒有用的資訊 |
| 空白欄位 | Mendoza → (空白) | 任何人 |
最常見也最麻煩的問題是過度合併(over-merging):某個身分錯誤地對應到現實中的多個人。真正困難的是沒有標準答案可以對照——如果真有標準答案,拿它來比對就好,根本不需要做身分解析。所以團隊只能用啟發式規則找統計異常(例如算每個身分掛了幾個 email),最後仍得抽樣人工檢視。
人工抽樣慢,而且抽得少就估不準。在健康的圖譜裡,過度合併是罕見事件,要把罕見率估到誤差正負 1% 以內,需要超過 1,000 個樣本。作者群的推論是:如果 LLM 能以人類水準判斷這類身分,就開幾十個平行去跑,10 萬個身分幾秒鐘就能評完。
實驗怎麼做的
他們用華盛頓大學健康計量與評估研究所(IHME)的 pseudopeople 工具,模擬一座虛構的美國小鎮,從多個政府來源產生居民紀錄:人口普查、兩份家戶調查、WIC 婦幼營養補助、社會安全局、W-2 與 1040 報稅表,涵蓋 2020 到 2040 年。再刻意加進各種貼近真實的資料錯誤。
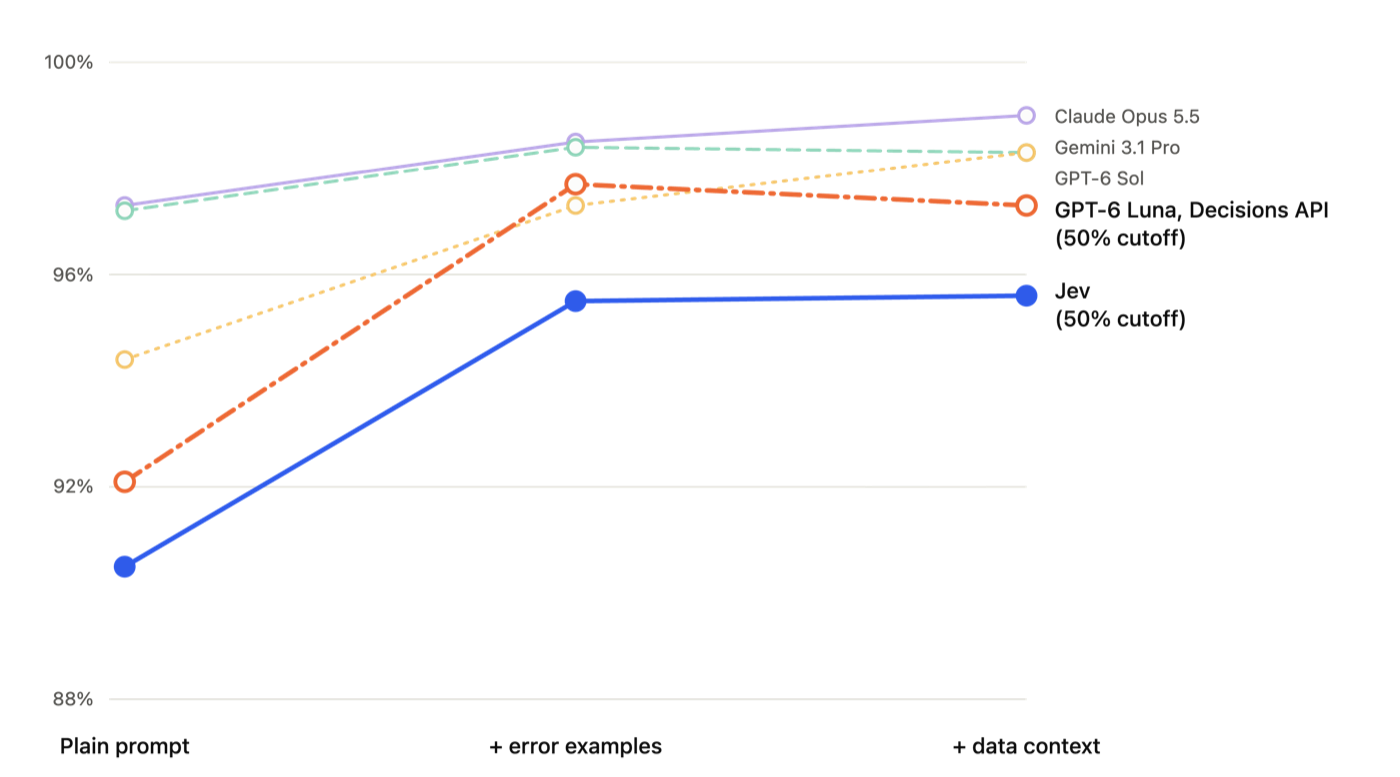
從這些紀錄建出 1,000 個身分,一半是一個人加上雜訊紀錄,一半是過度合併。接著把提示詞分成三層餵給模型:任務定義(你是稽核員,判斷這組紀錄是否真的屬於同一個人)、錯誤範例(錯字、誤讀、月日互換、暱稱、佔位名、空白欄位)、資料背景(紀錄來自哪些政府來源)。
結果是:錯誤範例是每個模型獲益最多的一段。資料背景那段對前沿模型最多加一個百分點,對決策模型完全沒幫助。作者猜測,決策模型並不是真的在推理,給它背景知識沒有用。
單獨使用時的成績
| 模型 | 準確度 | 偽陽性 | 偽陰性 | 每個身分耗時 | 每 1,000 個成本 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | 99.0% | 3 | 7 | 2.2 秒 | 3.86 美元 |
| Gemini 3.1 Pro | 98.3% | 10 | 7 | 4.2 秒 | 4.48 美元 |
| GPT-6 Sol | 98.3% | 14 | 3 | 2.1 秒 | 2.50 美元 |
| GPT-6 Luna(70% 門檻) | 97.3% | 14 | 13 | 0.17 秒 | 0.10 美元 |
| Jev(60% 門檻) | 95.7% | 22 | 21 | 0.15 秒 | 0.05 美元 |
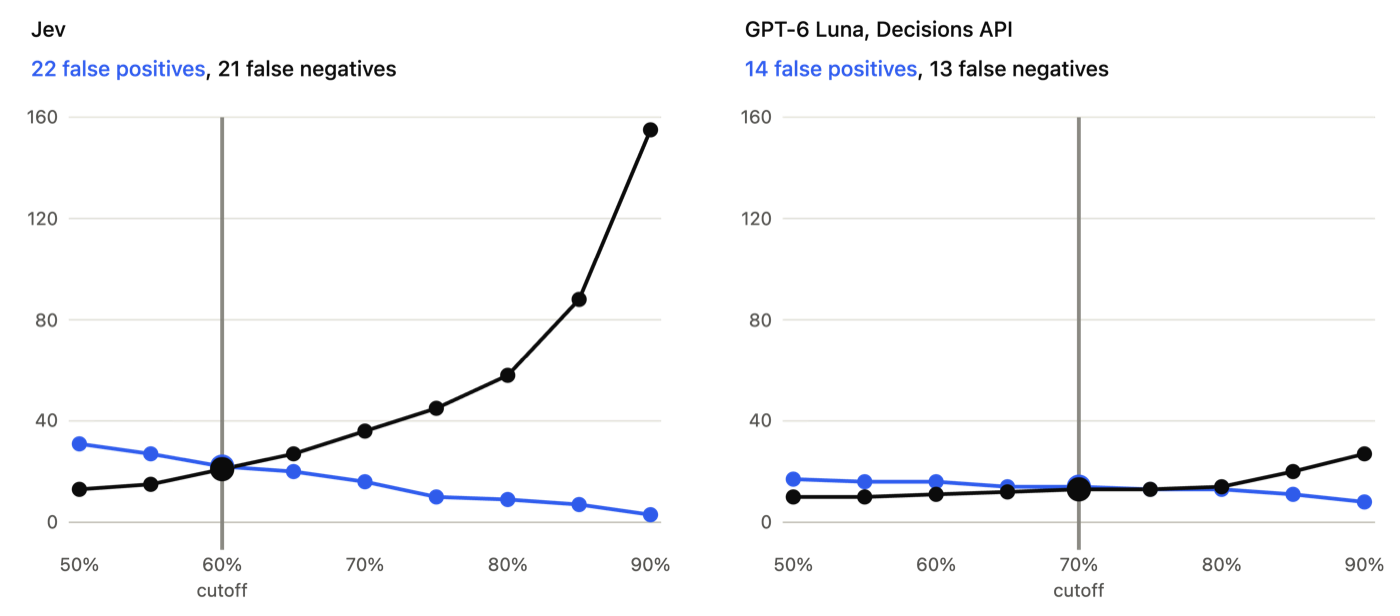
一開始兩款決策模型都用 50% 信心門檻,但這個數字是隨意選的。調整後發現門檻對 Jev 影響很大、對 Luna 影響很小,最後分別取 60% 與 70%,各自讓準確度最大化。這一步也順便暴露兩款模型的性格差異:Jev 換門檻能改的錯誤類型多,Luna 幾乎不動。
把難度拉高
第一輪跑完,Luna 看起來非常好,於是把測試改成只挑棘手案例。陷阱分兩類:第一類是同一個人的紀錄在生日或名字這種重要欄位互相矛盾;第二類是高度相似的過度合併,例如雙胞胎、父子同名、兩個同名的人。
範例長這樣:社會安全局有一筆 Christopher Brentley Carpenter,WIC 有一筆 Christopher B Carpenter 掛 2023 年 2 月 24 日出生,社會安全局另一筆是 Christopher Brian Carpenter 掛 1986 年 2 月 13 日,報稅表又是 Christopher B Carpenter 掛同一個地址。模型得判斷這四筆是幾個人。
難度一升,差距立刻出現。單獨使用的兩款決策模型都掉到 88% 到 89%,Opus 還有 95.1%,Luna 與 Jev 打平。
關鍵在信心校準,不在模型大小
作者挖答錯案例時發現一個模式,這也是整篇文章真正的重點。
Jev 犯錯時,信心多在 50% 附近。這是校準良好的模型該有的樣子。Luna 犯錯時,信心常不低於 90%,它相當過度自信。
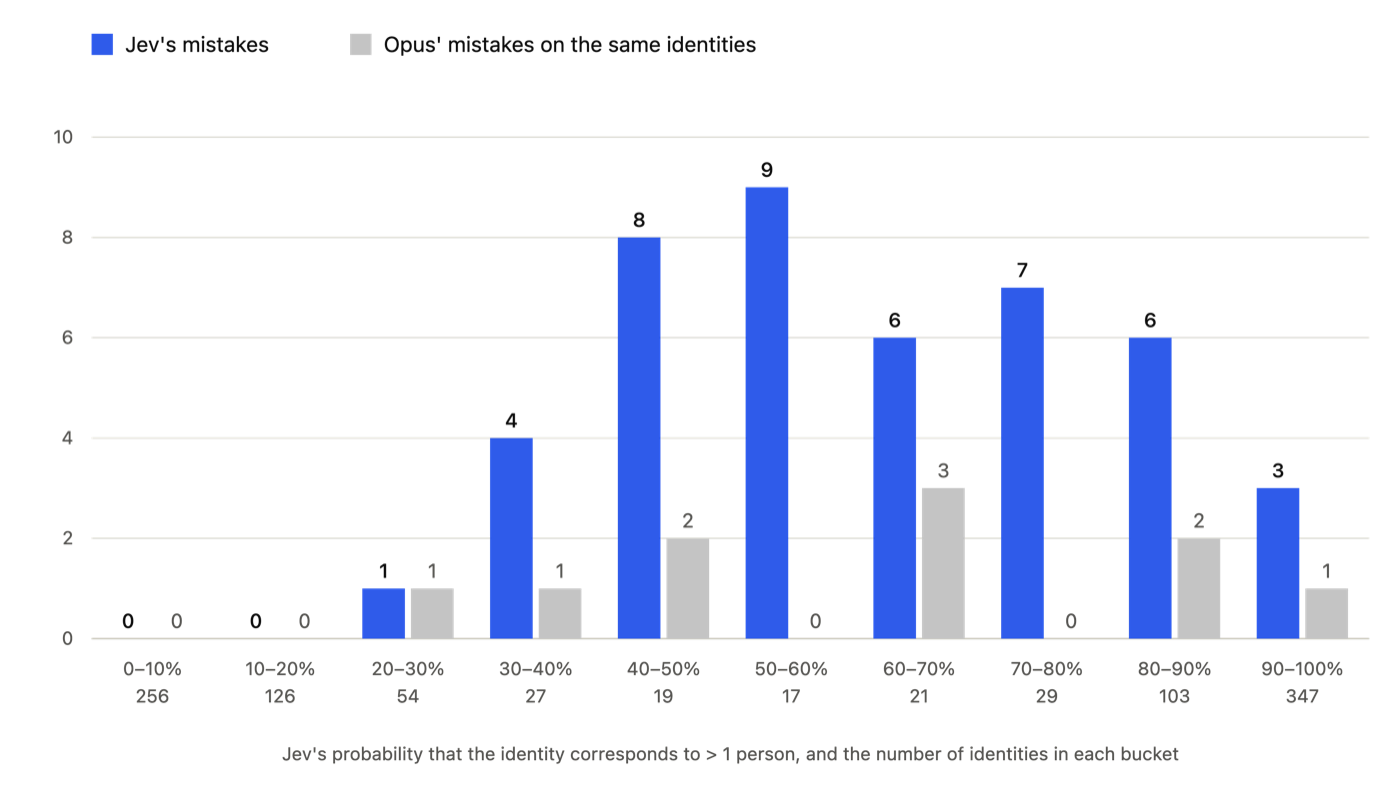
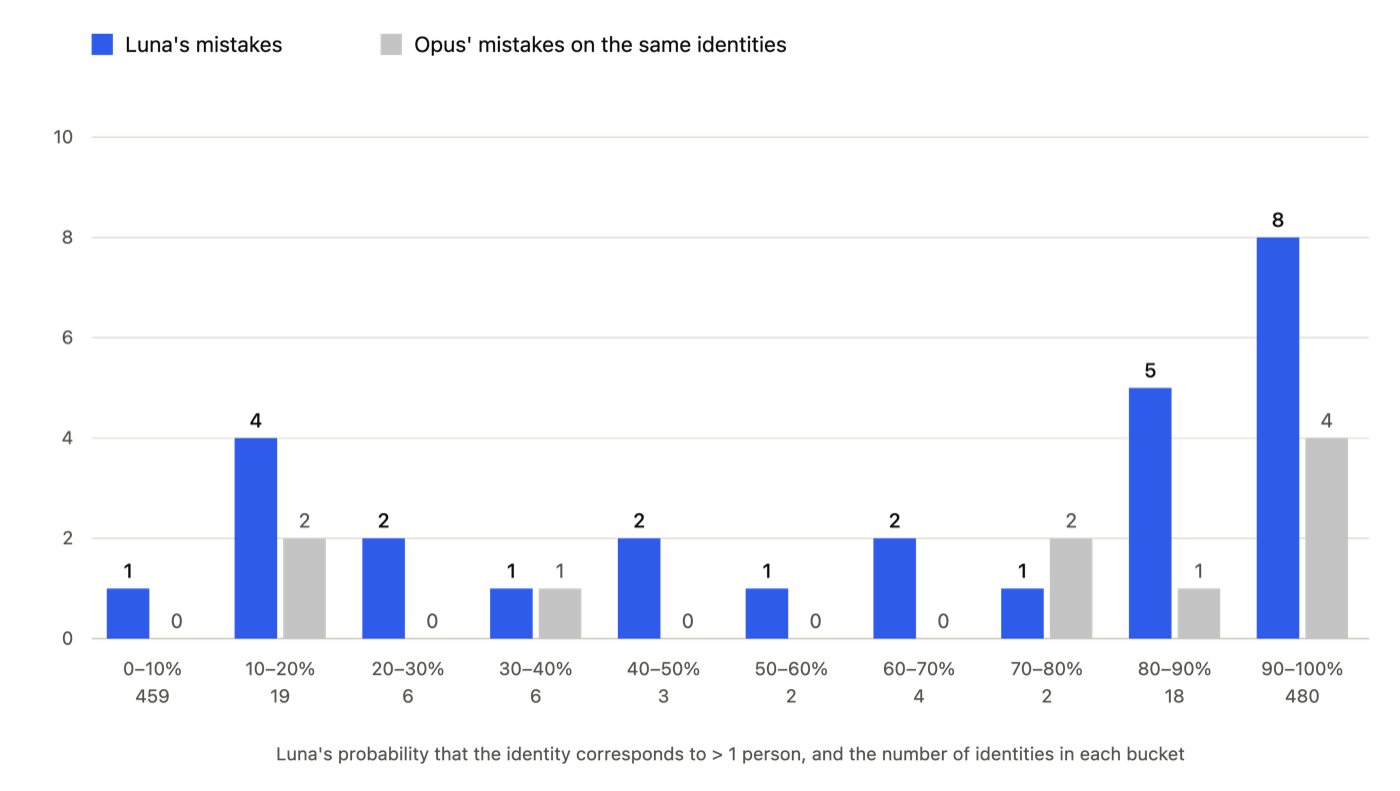
這件事為什麼重要?因為混合架構的運作方式就是「信心落在某個區間就轉給貴模型」。過度自信的模型,會把該升級的案例留在自己手上。它的錯誤不是隨機分布,而是集中在它最確定的地方,你連攔都攔不到。
混合架構與甜蜜點
做法很簡單:Jev 先判,信心落在 30% 到 90% 之間的案例轉給 Opus 複判。
| 送給 Opus 的信心區間 | 送出比例 | 準確度 | 每個身分耗時 | 每 1,000 個成本 |
|---|---|---|---|---|
| 完全不送(Jev 單獨) | 0% | 95.6% | 0.15 秒 | 0.05 美元 |
| 50–80% | 7% | 97.5% | 0.30 秒 | 0.31 美元 |
| 50–90% | 17% | 97.9% | 0.52 秒 | 0.71 美元 |
| 30–90% | 22% | 98.8% | 0.63 秒 | 0.88 美元 |
| 10–90% | 40% | 98.8% | 1.02 秒 | 1.58 美元 |
| 10–100% | 74% | 99.0% | 1.79 秒 | 2.92 美元 |
| 全部送(Opus 單獨) | 100% | 99.0% | 2.2 秒 | 3.86 美元 |
甜蜜點在送出 22%。再往上送到 40%,準確度一樣是 98.8%,成本卻幾乎加倍。
同樣的架構換成 Luna 先判,走 10% 到 90% 的區間,只送 6% 的案例,準確度 98.5%,成本 0.33 美元。在簡單測試上,混合式 Luna 其實更划算。
較難測試才是分水嶺
| 架構 | 第一輪準確度 | 第一輪成本 | 較難測試準確度 | 較難測試成本 |
|---|---|---|---|---|
| 單獨 Opus | 99.0% | 3.86 美元 | 95.1% | 5.39 美元 |
| Jev 先判,30–90% 送 Opus | 98.8% | 0.88 美元 | 95.3% | 2.94 美元 |
| Luna 先判,10–90% 送 Opus | 98.5% | 0.33 美元 | 91.6% | 1.15 美元 |
在難題上,混合式 Jev 的準確度追平單獨使用 Opus(95.3% 對 95.1%),成本只要 2.94 美元,Opus 要 5.39 美元。混合式 Luna 掉到 91.6%。
這個轉折是自動發生的。混合式 Jev 沒有改架構、沒有改提示詞,純粹因為它的信心分布在難題上往下移動,升級率就從 22% 自動升到 53%,花費隨難度自動加碼。這一點在實務上比準確度數字更有價值:你永遠不知道明天進來的資料有多髒。
HN 網友怎麼看
原文在 Hacker News 拿到 465 分、106 則留言(2026 年 11 月 7 日抓取)。討論沒有圍繞「這招好不好」,而是集中在四個更根本的問題。
第一,校準的結論被直接挑戰。 帳號 pcwelder 認為原文那兩張信心分布圖不足以證明 Jev 校準更好,他從圖估算,兩個任務上 Luna 的預期校準誤差(ECE)反而低 2 到 3 個百分點,並主張應該直接報 ECE。他補了一刀:Luna 確實愛給高信心,但它也更常答對,高信心區錯誤數多,只要整體通過率高,本身不構成缺點。
第二,作者沒報的升級率被人算出來了。 帳號 ezotony 用成本反推:(2.94 – 0.06) / 5.39 約 53%,這是較難測試送給 Opus 的比例,簡單測試只有約 22%,門檻相同。這個數字原文沒有列出來。
第三,這是不是通用的改進? 帳號 nico 提醒,這是身分解析這個特定任務的基準測試,標題那樣寫容易讓人誤以為是通用能力的改善。帳號 asar 說得更重:這類標題他已經麻木,「證明」往往只證明了它自己那個沙盒情境。不過也有人反向提供了實測:帳號 pkulak 把一個「評審」接進既有的 Jev 設定,原本要很脆弱的提示詞才能讓測試全過,加個逗號就多壞十個測試,現在提示詞砍回基本款照樣過。
第四,架構定位與真正的難點。 帳號 theptip 說這就是 Model Router,問題永遠是同一個:笨模型怎麼知道自己該升級?有些難題是明顯的已知未知,真正的問題是模型不知道自己不知道。帳號 bastawhiz 回應得很漂亮:你不可能事先知道需不需要升級,因為你得先升級才會知道。所以,重點不是「模型有多確定」,而是「賭注有多大」。帳號 beefsack 補了反向架構的實測:他做過讓便宜模型主動呼叫強模型的系統,但「它們連什麼時候該呼叫都不太會判斷」。
還有一整串在談倫理。 帳號 vouwfietsman 直指這篇是把「把資料對應到真人」變得更便宜、更有效率,實質上是 AI 加持的隱私侵害,而且便宜四倍。有人回說數位化紙本病歷也需要這種能力,他反駁核分裂可以發電也可以造武器,不代表兩邊的道德等價。帳號 gnarlouse 的結論是諷刺:「謝謝你們讓定向廣告和監控國家更強大。」
任務設計本身也被挑錯。 帳號 angry_octet 指出原文範例「Valentino → Female Child」有問題:Valentino 是男名,否則就該是 Valentina。他順帶追問日期格式:17/08/22 到底是 2017 年還是 2022 年?04/06/2009 在北美內外是相反答案。沒有文化背景、地點、文件類型,你就可能判錯。帳號 jwpapi 從這裡推到更根本的質問:所有案例真的可判定嗎?AI 是不是該允許棄權(abstain)?為什麼要 agentic 解,而不是拆成很多小的 yes/no 規則題?他的建議是遇到無法辨識的文件,回應不該是 INVALID,而該是 UNDECIDED。
最後一串在吵英文。帳號 intervolz 說「4x lower」數學上超尷尬,帳號 Terr_ 主張該寫 0.25x:如果 3x 是原值的 300%,0.25x 就是原值的 25%。這條爭論對中文讀者沒什麼殺傷力,但值得記住原文標題的「四倍」其實是「四分之一」。
這篇能帶走什麼
三件事。
第一,校準是便宜模型唯一真正值錢的屬性。 決策模型的準確度天花板就在那裡,你買不到 Opus 的判斷力。但你可以買到「知道自己不行」的誠實度,而那個誠實度決定了混合架構能不能運作。
第二,先量測再花錢。 不要假設便宜模型過度自信,也不要假設貴模型一定值得升級。拿你自己的資料跑一次,畫出信心分布,你才知道轉送區間要設在哪裡。原文設的 30–90%,是他們自己資料上的答案,不是你的。
第三,這組數字有保鮮期。 帳號 mannyv 的提醒很實在:這些結果只對特定版本的模型、特定參數成立。另一位帳號 netshade 提供了活生生的反例:Haiku 5.5 出來後,他手上任務的成本差距幾乎立刻消失,Jev 的毫秒級延遲,被鏈路裡的其他延遲淹沒,量不出差異。這類架構決策每隔幾個月就得重算一次。
譯註(非原文)
- Jev:TypeSafe 推出的「系統一模型」(system one model),屬於決策模型一類,針對單一條件回傳 0 到 1 的信心分數,延遲在毫秒級。
- GPT-6 Luna:OpenAI 的小型模型,另有 Decisions API 版本可回傳信心分數。HN 討論裡有人指出 Luna 本質上是小 LLM 加固定 JSON 輸出,不是嚴格意義的決策模型,也有人指出確實存在 Luna 的 decision 版本,原文的歸類引起爭論。
- Hightouch:做客戶資料平台(CDP)與資料啟用的廠商,本文是他們在自家身分解析管線上的內部實驗。
- 「4x lower」:原文字面如此,數學上等於原值的四分之一。這個寫法在 HN 被大量吐槽,有人主張該寫 0.25x。
- 原文中 Jev 與 Luna 的信心分布圖為直方圖圖檔,本網站已轉載原圖,圖說由譯者補上。
- 原文的中文譯名:作者 Albert Jin(阿爾伯特·金)、Neil Desai(尼爾·德賽)、Delaney Mackenzie(德萊尼·麥肯錫),原文發表於 2026 年 11 月 4 日。
懶人包直連(手機版建議):https://static.blog.derekhsu.net/jev-hybrid-opus
原文來源:A Jev that can ask Opus for help gives Opus accuracy at 4x lower cost(Hightouch 部落格,2026 年 11 月 4 日)