Kolibri 蒸餾爭議拆解:哪些是自建的,哪些借了中美模型
借了,但沒全借。自建的是權重、架構、管線、德語料大頭;借的是改寫器、標註器、一部分合成料。版本比例、API通道、Gemma衍生條款三題未答。
借了,但沒全借。自建的是權重、架構、管線、德語料大頭;借的是改寫器、標註器、一部分合成料。版本比例、API通道、Gemma衍生條款三題未答。
Kolibri 78B MoE 德語輸 Qwen3.8 27B 九分,但算力便宜、主權合規、地端可跑。公部門買的不是跑分,是斷供那天還有沒有得跑。
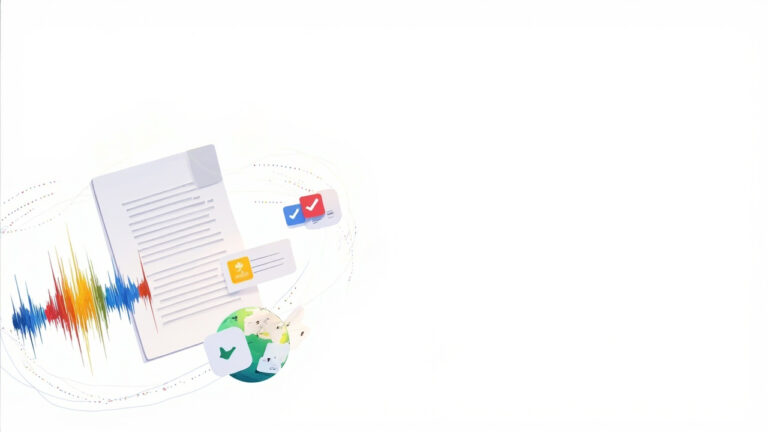
Google 在 2026-08-26 推出專用語音轉文字模型 Gemini 3.5 Transcribe,主打「智慧聽寫」——不是逐字稿,而是直接把口語(含自我修正、填充詞)轉成乾淨格式化文字。串流/批次兩個 API、85+ 語言、AA-WER 2.6% 排行第 5、token 計費約 $0.005/分鐘。
這篇Google研究部落格的文章介紹了機器學習(ML)領域的最新進展,特別是如何利用ML來提高ML工作負載的效率。文章強調了ML編譯器在優化用戶模型方面的重要性,並介紹了新的“TpuGraphs”數據集,這是針對大型張量計算圖的性能預測數據集。此外,文章還提出了一種名為“Graph Segment Training”的新方法,用於擴展圖神經網絡(GNN)訓練,以處理大型圖表。Google還舉辦了一場Kaggle競賽,參與者利用TpuGraphs數據集開發新技術,包括圖表剪枝/壓縮、特徵填充值的選擇、節點特徵的重要性,以及跨配置注意力機制的應用。這些進展將有助於在系統中進一步應用ML,特別是在結構化數據和人工智能研究方面。